

世界モデルの機能的分類
見るモデル、動かすモデル、行動するモデル
世界は言葉だけでできているわけではない。
言語モデルは概念を扱うことに長けている。文章を読み、推論し、説明し、抽象的な関係をつかむことができる。しかし、私たちが生きている世界は、言葉よりも先に空間、時間、物体、力、光、摩擦によって成り立っている。
そのため、AIにとって次の大きな課題は「世界を記述すること」ではなく、「世界の中で成り立つことを理解すること」だと言える。ここで重要になるのが、いわゆる世界モデルである。
ただし、現在「世界モデル」と呼ばれているものは非常に幅が広い。動画を生成するAIも、ロボットの行動を決めるAIも、物理シミュレーションを行うシステムも、同じ言葉で語られることがある。そこで必要なのは、世界モデルを名前ではなく、機能によって分類する視点である。
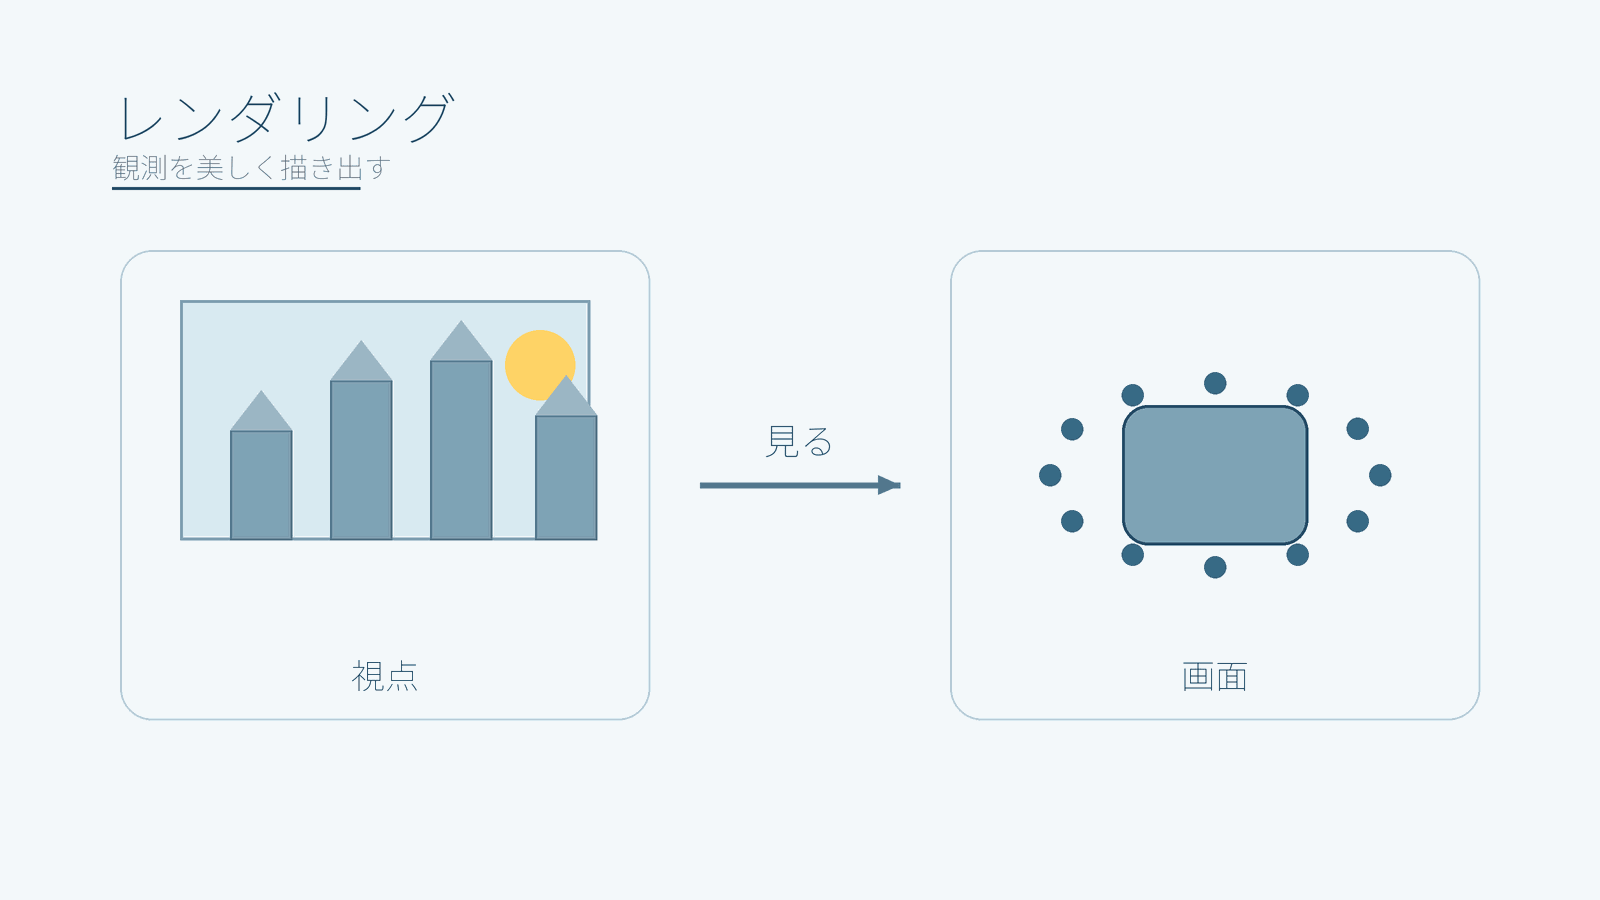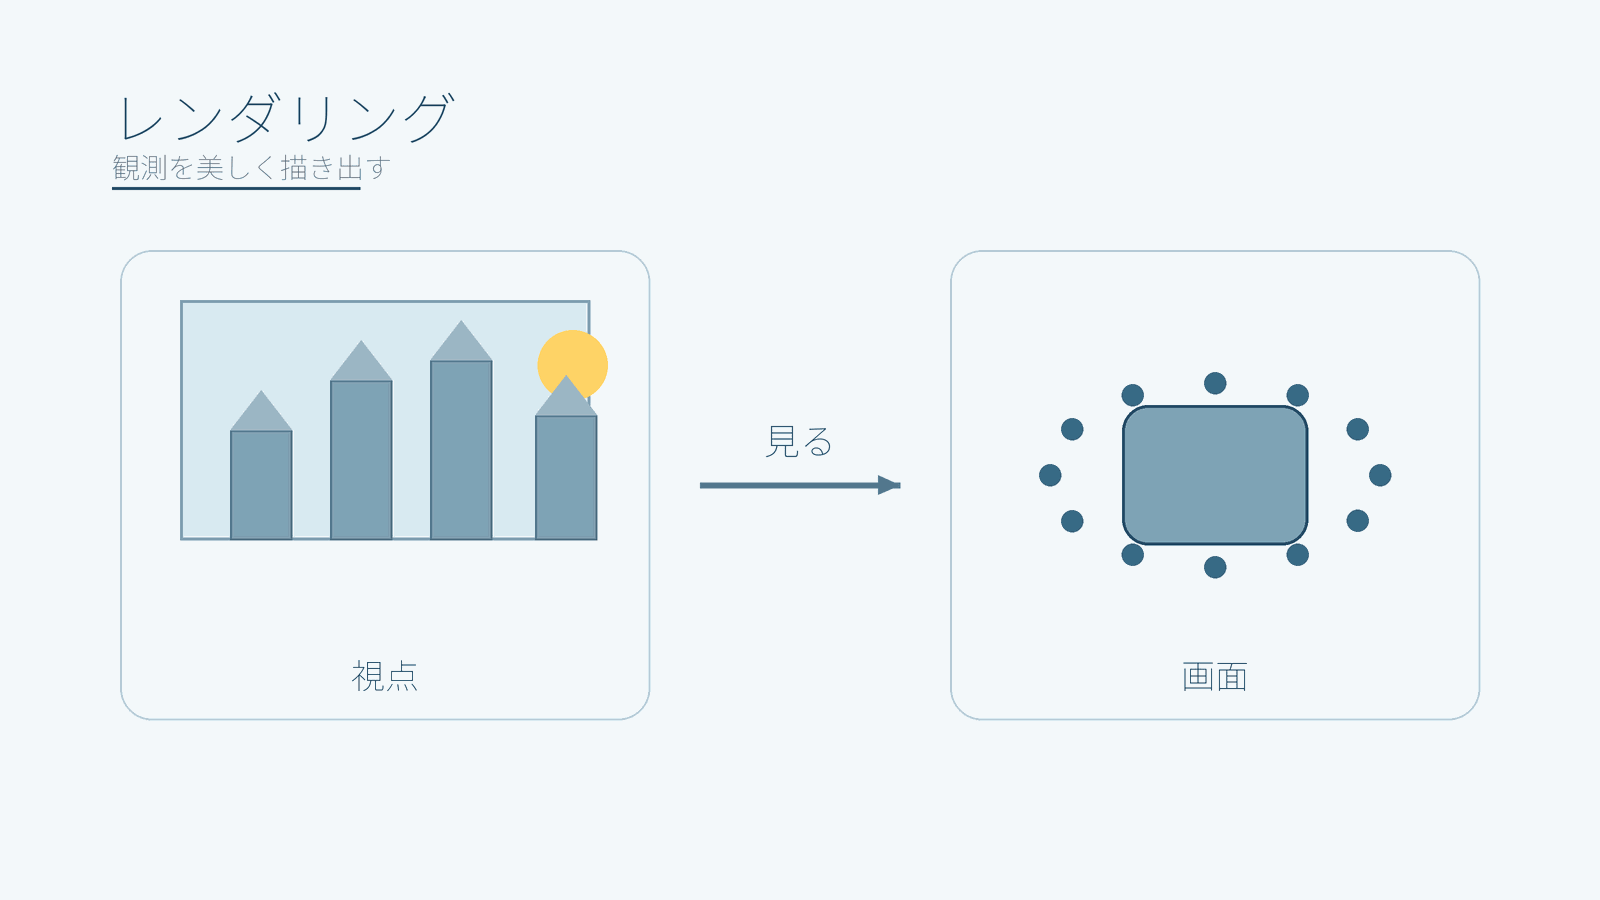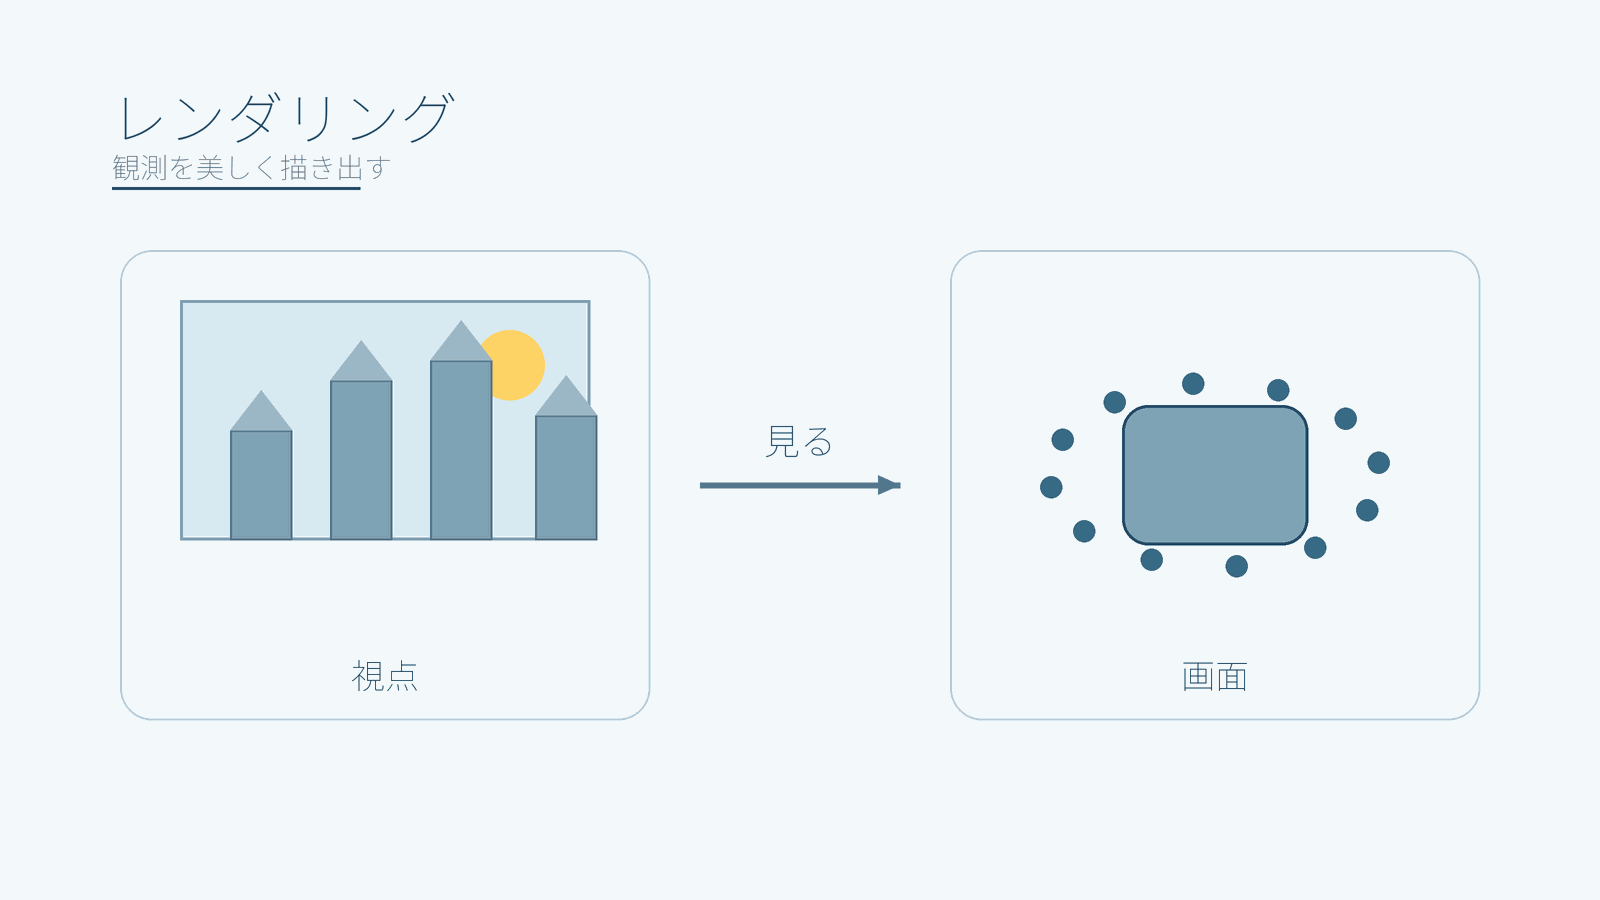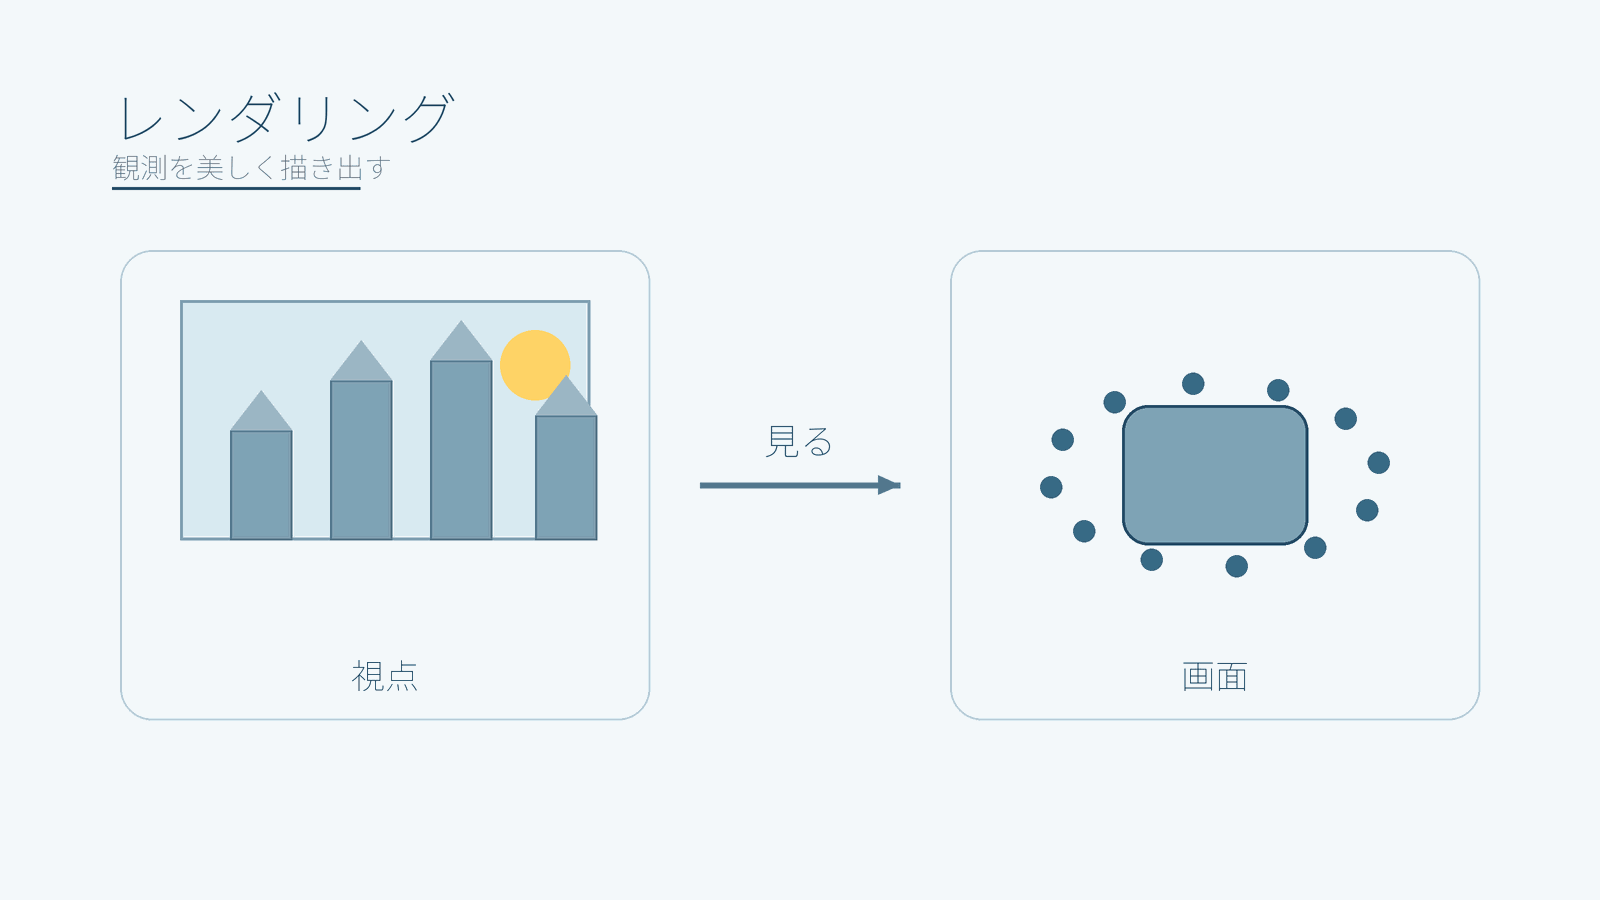
第一の機能は「レンダリング」である。
これは、世界を人間が見られる形に変換する能力だ。たとえば、テキストから映像を生成するモデルや、視点を変えて風景を描き出すモデルがこれに当たる。レンダラーにとって重要なのは、見た目の自然さや美しさである。しかし、見た目が正しいことと、構造が正しいことは同じではない。映像の中の建物が美しく見えても、その内部空間や物理的な整合性が保たれているとは限らない。
第二の機能は「シミュレーション」である。
これは、世界の構造や物理的変化を扱う能力である。物体の位置、形状、質量、衝突、変形、流体、摩擦などを含めて、世界がどのように変化するかを計算する。レンダラーが「どう見えるか」を出力するのに対して、シミュレーターは「何が起きているか」を扱う。建築、ロボット訓練、自動運転、ゲーム、製造業のデジタルツインなどでは、この機能が不可欠になる。
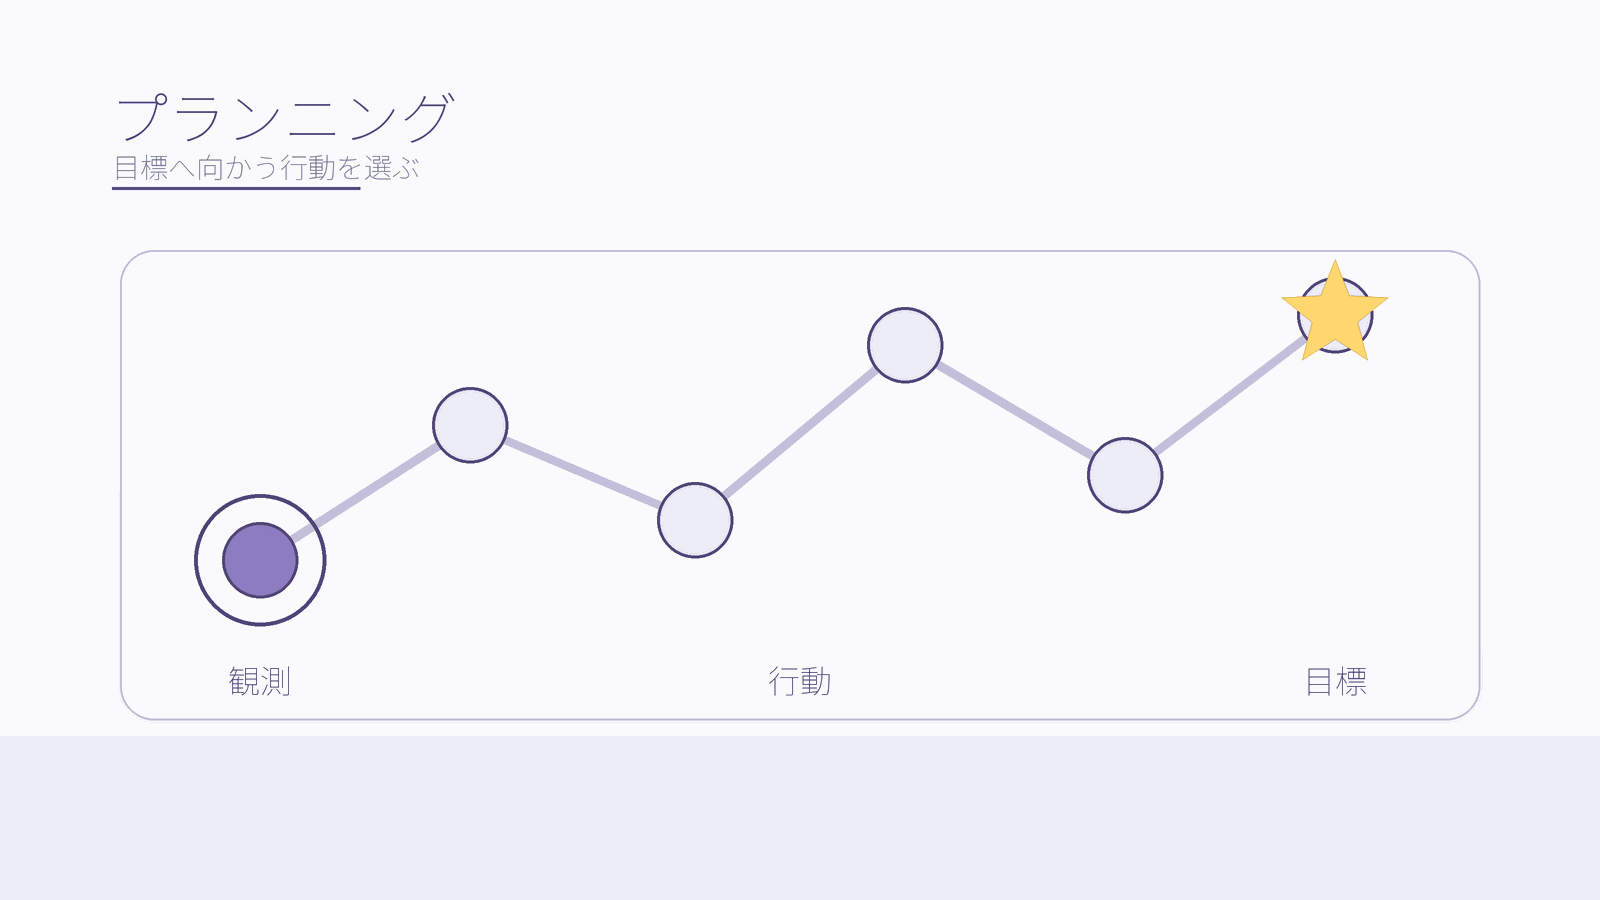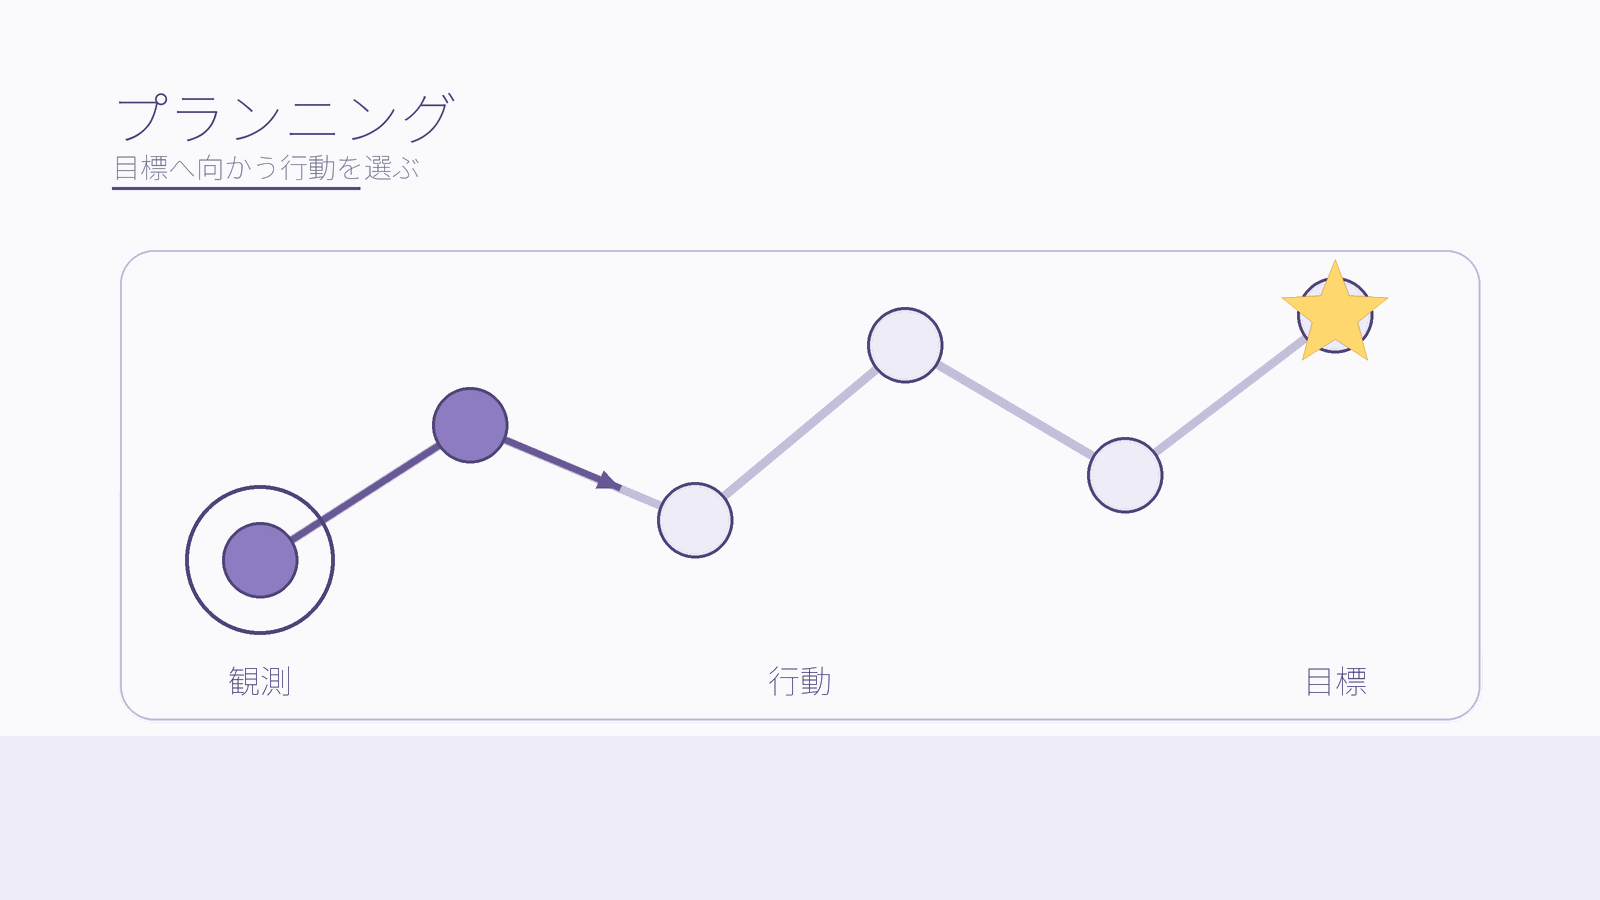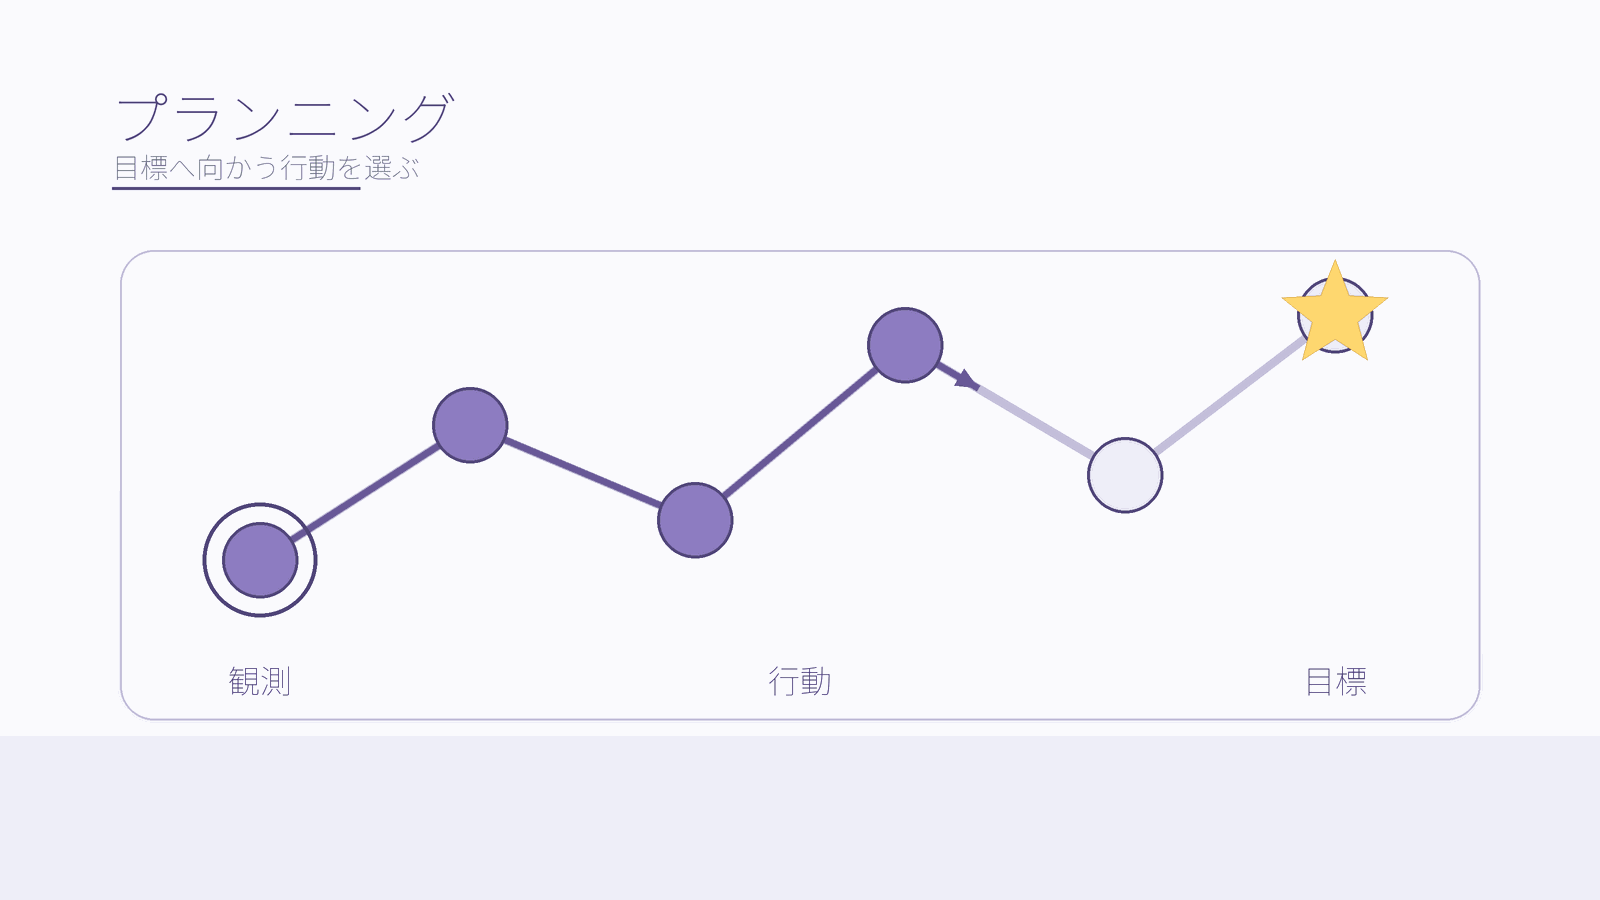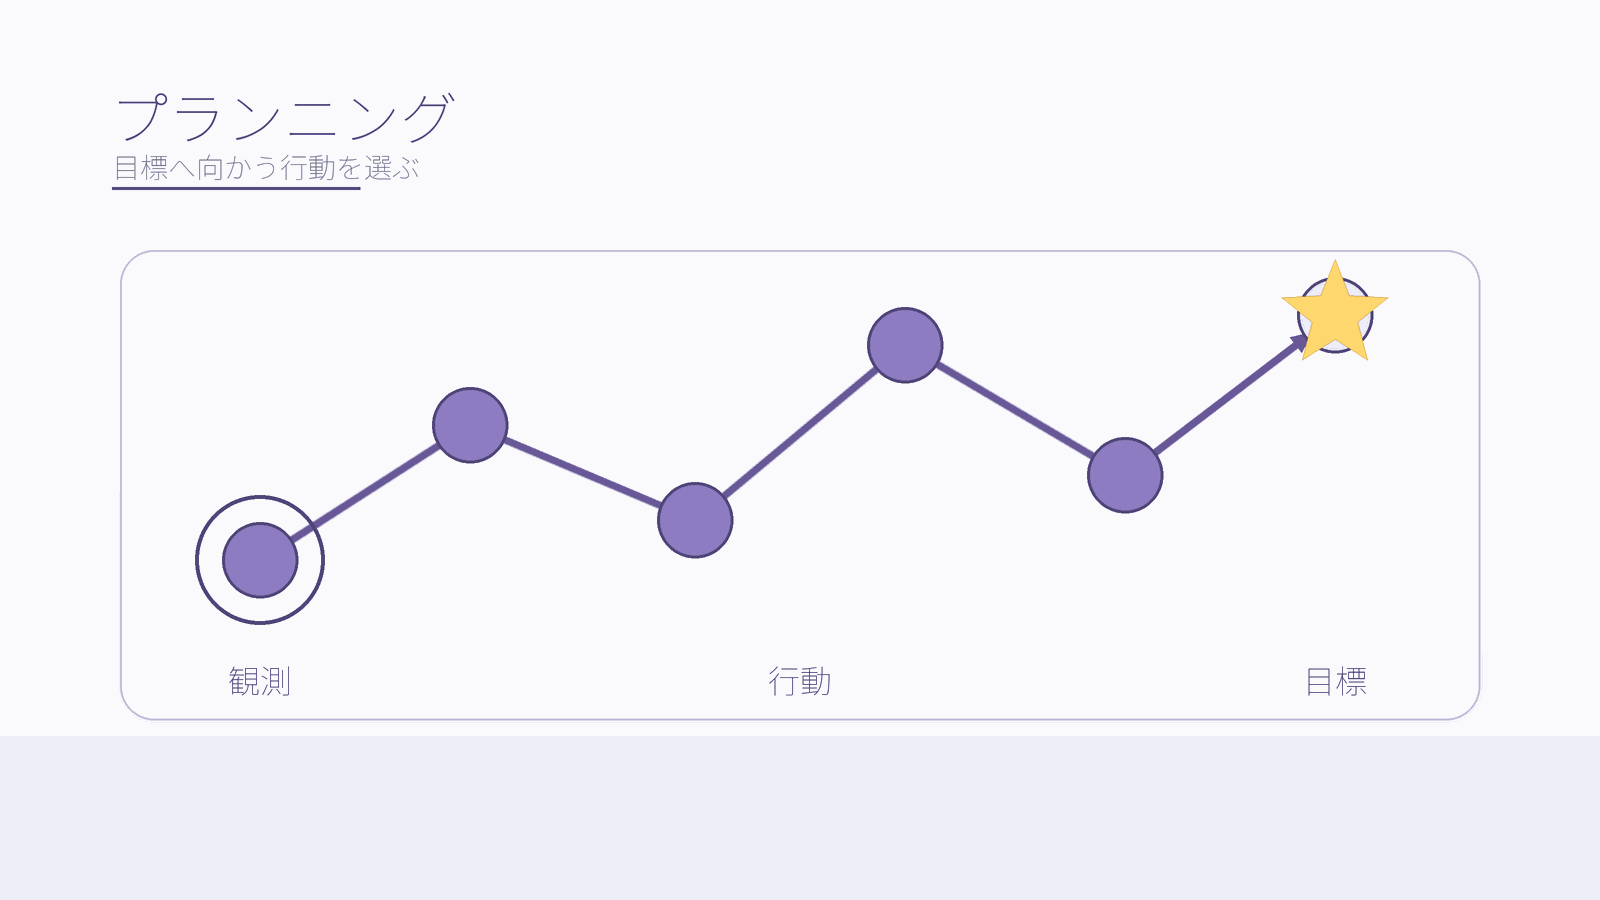
第三の機能は「プランニング」である。
これは、観測と目標に基づいて、次に何をすべきかを決める能力である。ロボットがコップを持ち上げる、車が交差点を通過する、人型エージェントが部屋を片づける。こうした行動には、単なる認識ではなく、結果を予測しながら行動を選ぶ能力が必要になる。
私はここに、第四の機能として「校正」または「検証」を加えるべきだと考える。
世界モデルは、どれほど精巧であっても現実そのものではない。生成された3D空間が見た目には自然でも、寸法がずれていたり、物理的に不可能な構造を含んでいたりすることがある。したがって、世界モデルには「自分の出力が現実とどれだけ一致しているか」を測る仕組みが必要になる。これは、AIが実世界で信頼されるための重要な条件である。
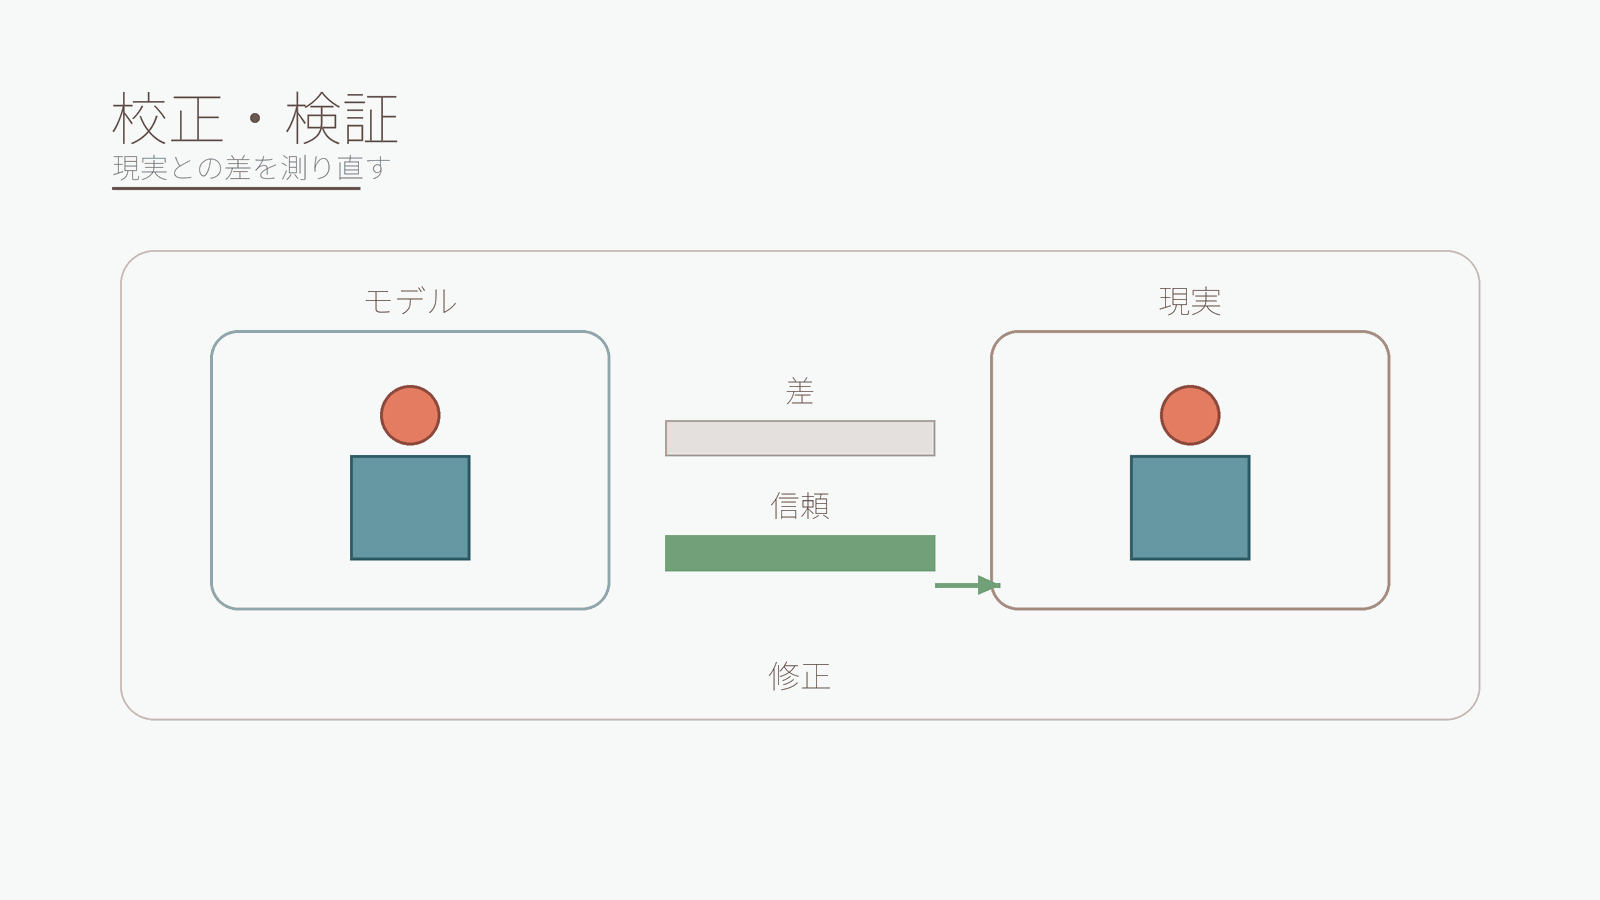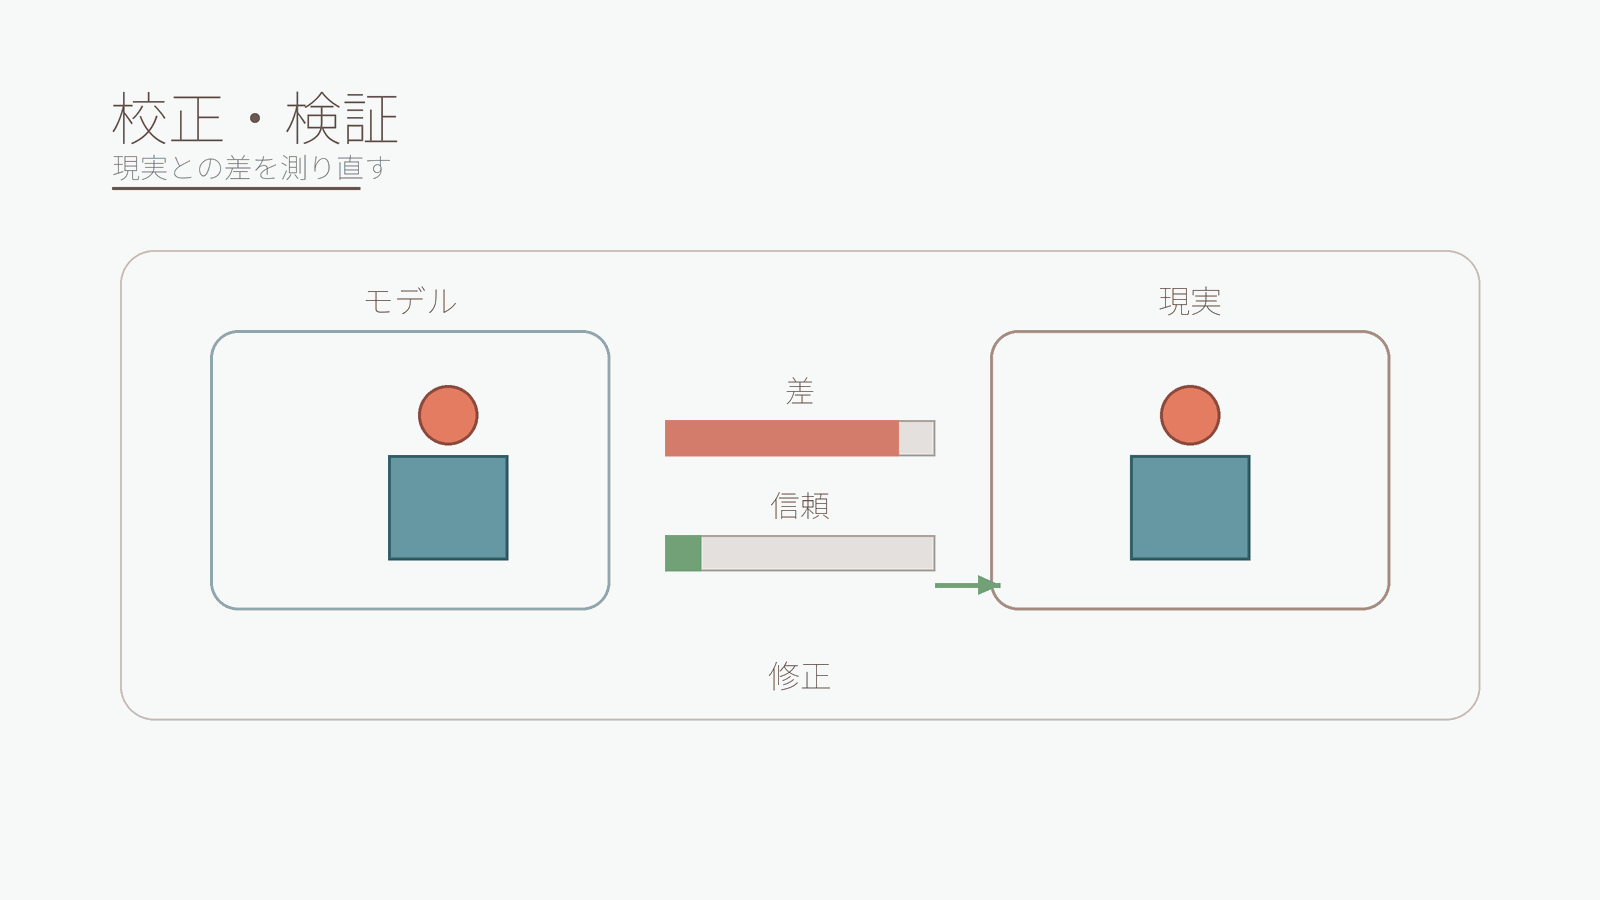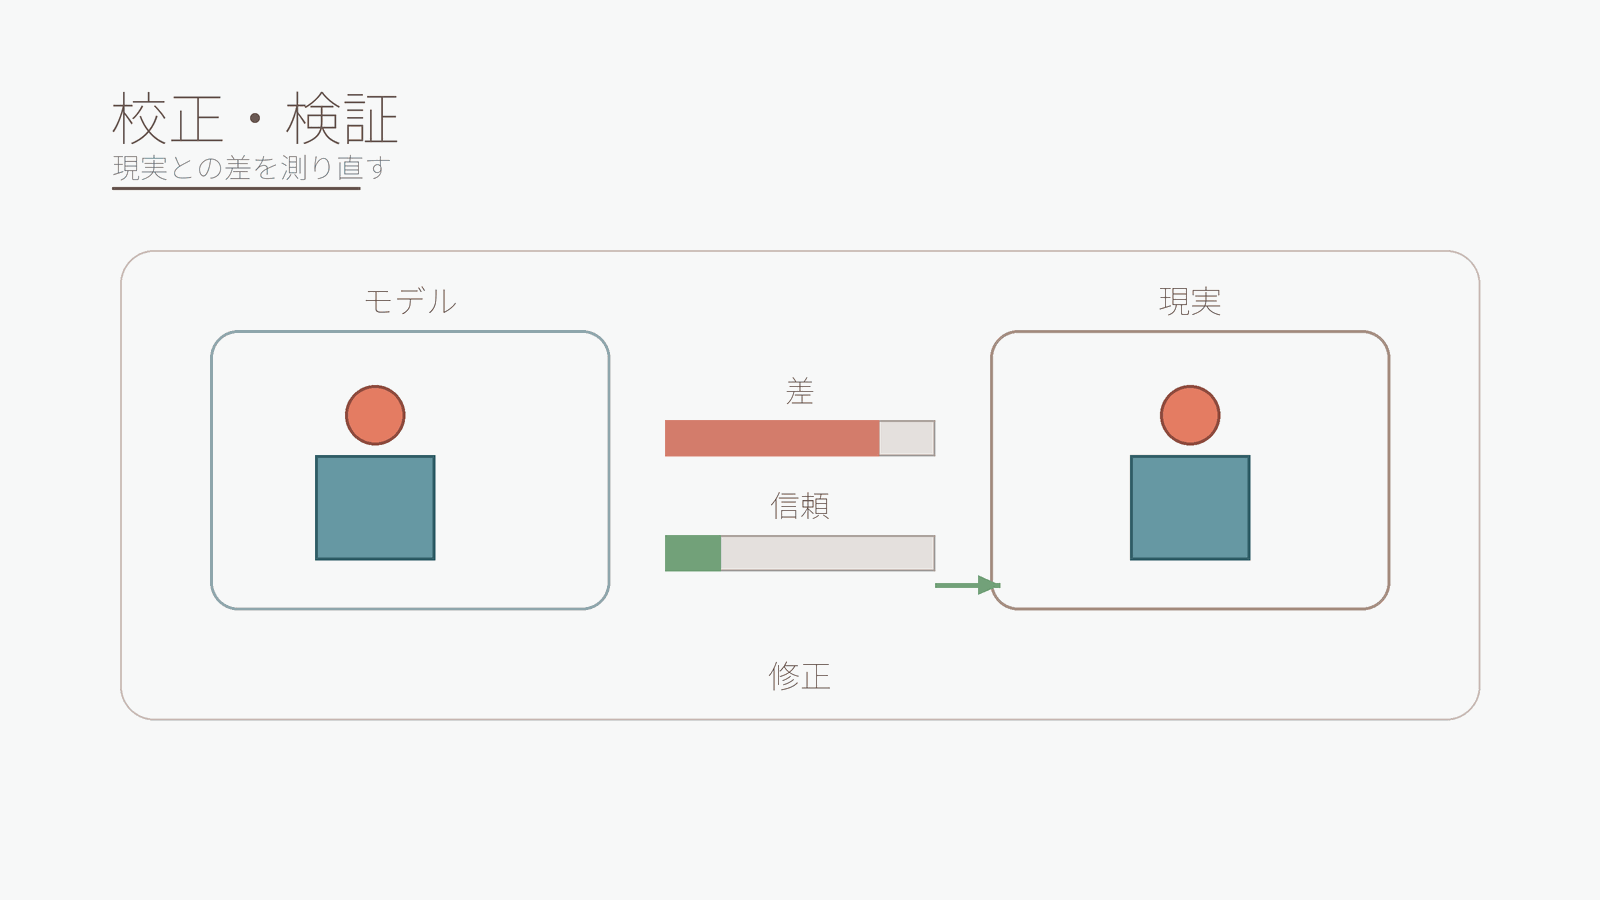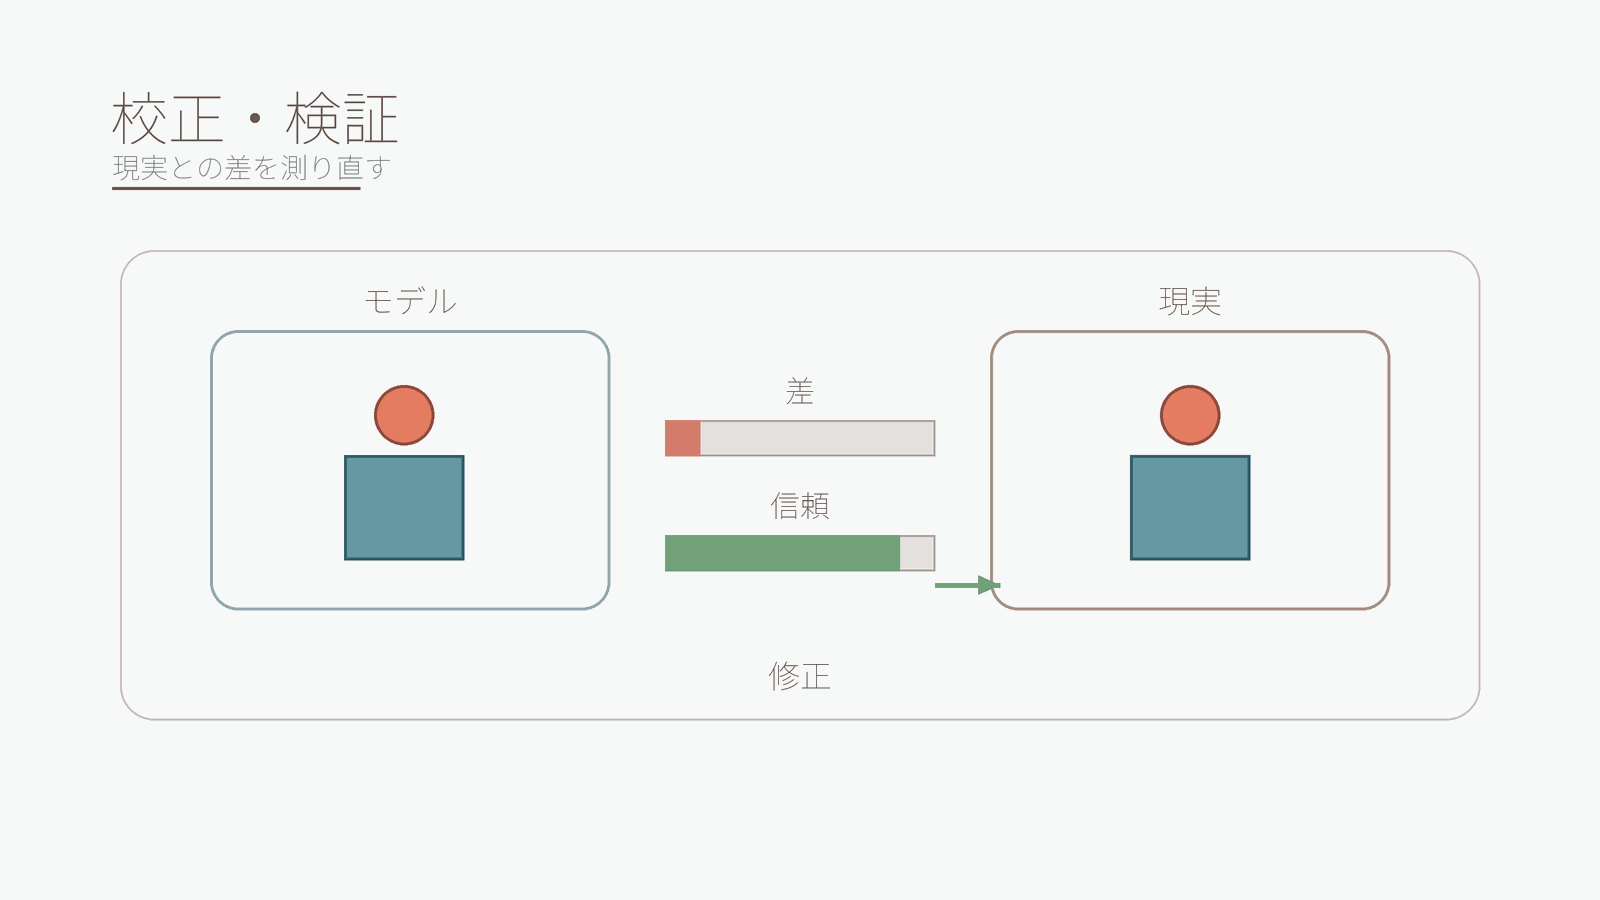
私はここに、第四の機能として「校正」または「検証」を加えるべきだと考える。
この観点から見ると、世界モデルの発展は単なる映像生成の進化ではない。最終的に求められるのは、見ること、動かすこと、行動すること、そして誤差を修正することを統合したモデルである。
言語モデルは、機械に世界について語る力を与えた。
世界モデルは、機械に世界の中で考え、試し、失敗し、修正し、行動する力を与える。
その意味で、世界モデルの核心は「世界をきれいに描くこと」ではなく、「世界の制約の中で成り立つ可能性を扱うこと」にある。

